Aby spisać fokus, zachowaj nagranie i ustal jasne zasady transkrypcji, przygotuj szkic, a następnie odsłuchuj źródło, sprawdzając każdą istotną wypowiedź. Nie usuwaj niepewnych słów, nakładania się głosów, przeczeń ani warunków. Potrzebujesz zapisu dyskusji, którego treść można odnaleźć w źródle, bez cichego łączenia kilku osób w jeden pozornie pewny akapit.
Przejdź do transkrypcji zapisanego nagrania
Ustal, co musi pozostać w transkrypcji
- Przy analizie treści lub tematów uzgodnij, które wypełniacze można pominąć, zachowując każdą wypowiedź, pytanie, przeczenie i warunek. Nie przerabiaj słów uczestnika na mocniejsze stwierdzenie.
- Przy analizie interakcji zachowaj wymagane przez metodę przerwania, pauzy, śmiech i krótkie odpowiedzi. Automatyczna interpunkcja i podział na rozmówców nie potwierdzają tych szczegółów.
- Jeśli potrzebujesz kilku cytatów, zachowaj fragment z odniesieniem do źródła, a resztę sesji oznacz jako niesprawdzoną. Kilka zweryfikowanych cytatów nie jest pełną transkrypcją.
Przed redakcją zapisz zasady na początku dokumentu roboczego. Zachowaj pierwotny szkic i rejestr zmian. Transkrypcja, Twoja interpretacja oraz podsumowanie wyników pełnią różne funkcje; rozdziel je, aby późniejszy czytelnik widział, które słowa pochodzą od grupy.
Zdefiniuj zasady w dokumencie — te nazwy nie oznaczają powszechnie obowiązujących reguł. Poniżej ta sama wypowiedź wymyślona przez autora w dwóch wariantach zapisu. Żaden nie jest zaobserwowanym wynikiem narzędzia.
- Źródło wymyślone przez autora: „Yyy, j-ja lu— lubiłem te, te przypomnienia [pauza], ale nie codziennie [śmiech]”.
- Wersja lekko zredagowana na potrzeby tego przykładu: „Lubiłem te przypomnienia, ale nie codziennie”. W tym przykładzie analizy treści pomijamy wypełniacz, powtórzone sylaby i słowa, urwany początek słowa oraz poboczne znaczniki pauzy i śmiechu. Zachowujemy pełną wypowiedź, przeczenie i warunek. Jeśli czas, wahanie lub śmiech są istotne dla Twojej metody, należy je jednak zachować.
- Wersja szczegółowa, dosłowna w tym przykładzie: „Yyy, j-ja lu— lubiłem te, te przypomnienia [pauza], ale nie codziennie [śmiech]”. Zachowujemy słyszalny wypełniacz, powtórzenie, urwane słowo, pauzę i śmiech, bez przypisywania emocji i bez nadawania długości niezmierzonej pauzie. Dokładniejsza analiza interakcji może wymagać specjalistycznego systemu zapisu.
- Wersja lekka nie może zmienić się w „Lubiłem codzienne przypomnienia”. Zachowaj szkic źródłowy i odnotuj wybraną regułę redakcji. Pominięcie zdarzenia zgodnie z jawną konwencją nie dowodzi, że ono nie wystąpiło.
Stosuj spójną legendę oznaczeń
To niewielka legenda robocza na potrzeby tego poradnika; przed transkrypcją dostosuj ją i opisz. Nawiasy kwadratowe zawierają redakcyjne oznaczenia zdarzeń lub niepewności, a nie słowa automatycznie uznane za sprawdzone.
- [niepewne słowo] / [niesłyszalne] — Nie można ustalić słowa albo fragmentu nie słychać dostatecznie wyraźnie, by go spisać. Dodaj czas względem źródła; ewentualną propozycję słowa zachowaj w notatce z kontroli, poza cytatem.
- rozmówca nieustalony — Nie ustalono, kto zabrał głos w tej wypowiedzi; zrozumiałe słowa nadal można zapisać. Sąsiednia etykieta, miejsce przy stole czy głośniejszy głos nie są dowodem.
- [nakładanie A: słowa] — Takie same znaczniki A w osobnych wierszach wskazują fragmenty wypowiadane jednocześnie w ilustracji. A to lokalne odniesienie do nakładania się głosów, nie kod uczestnika. Zaznacz tylko zakres ustalony odsłuchem; jeśli słowa lub granice są niejasne, wpisz [nakładające się wypowiedzi] z odniesieniem czasowym, zamiast uzupełniać luki.
- [pauza] — Słyszalna przerwa bez deklarowanej długości. Zmierzony czas dopisz tylko wtedy, gdy rzeczywiście go ustalisz i wymaga tego metoda.
- [śmiech] — Słyszalny śmiech, bez dopisywania zakłopotania, zgody czy innej wywnioskowanej emocji. Jeśli nie wiadomo, kto się śmieje, pozostaw przypisanie nieustalone.
- lu— / j-ja / te, te — Urwane słowo albo powtórzona sylaba lub wyraz, zachowywane zgodnie z przyjętą konwencją. Nie kończ porzuconego słowa na podstawie kontekstu.
Prowadź metrykę źródła i osobny klucz uczestników
- Zapisz identyfikator sesji, oryginalną nazwę pliku, długość i właściwą datę nagrania. Chroń kopię główną i pracuj na kopii, którą wolno Ci przetwarzać.
- Używaj stałych kodów, np. M dla moderatora i P1, P2 dla uczestników. Jeśli kilka sesji używa P1, dodaj identyfikator grupy. Klucz z prawdziwymi nazwiskami przechowuj oddzielnie, z odpowiednią kontrolą dostępu.
- Sprawdzając, kto mówił, korzystaj z przedstawienia się uczestników, dozwolonej notatki o miejscach albo dopuszczonego materiału wideo. Sama lista osób czy miejsce nie potwierdzają autora każdej wypowiedzi. Ludzie przemieszczają się, mówią cicho lub korzystają z jednego mikrofonu.
- Przy kilku ścieżkach lub fragmentach zachowaj tożsamość każdego pliku i przesunięcie jego początku. Nie zakładaj, że czasy lub automatyczne etykiety Mówca 1 odpowiadają sobie w osobnych przesłaniach.
Kod nie gwarantuje anonimowości. Nazwiska wypowiedziane w dyskusji, pracodawcy, charakterystyczne doświadczenia i inne szczegóły nadal mogą identyfikować osobę. Stosuj spójne zamiany w oddzielnej kopii do udostępnienia i zapisuj zmiany. UK Data Service wyjaśnia, dlaczego samo usunięcie nazwisk nie wystarcza i dlaczego zarówno nadmierne, jak i zbyt małe usuwanie informacji może zaszkodzić zbiorowi danych. Zalecenia ochrony danych nie są zgodą na wysłanie nagrania badawczego do zewnętrznej usługi; warunki przetwarzania w projekcie ustal osobno.
Zalecenia UK Data Service dotyczące anonimizacji tekstu
Przed wysłaniem nagrania do usługi sieciowej potwierdź, że nagrywanie, transkrypcja, zewnętrzne przetwarzanie i planowane udostępnianie mieszczą się w zgodach projektu oraz wymaganiach instytucji. Inni uczestnicy słyszeli dyskusję, więc nie obiecuj gwarantowanej poufności grupy. Wytyczne UConn odnoszą te zagadnienia do własnego środowiska badawczego; Twoja instytucja lub projekt mogą mieć inne wymagania. Demo nie podejmuje za Ciebie decyzji o protokole badania ani udostępnianiu danych. Zastąpienie nazwisk w transkrypcji nie usuwa wypowiedzianych identyfikatorów z wysyłanego audio; przed przesłaniem do usługi osobno sprawdź oryginalne nagranie i zasady projektu dotyczące przetwarzania zewnętrznego.
Sprawdź długość podglądu przed przesłaniem
Obecny komponent audio ma limit pięciu minut na żądanie, ale początkowy limit plików w demo to 120 sekund, wspólnych dla audio i wideo. Przetwarzany jest najkrótszy z trzech zakresów: długość pliku, faktycznie pozostały czas i limit żądania. Wcześniejsze użycie może zmniejszyć saldo. Przed kontynuowaniem sprawdź Pozostały darmowy czas (audio) w potwierdzeniu. Usługa ponownie sprawdza saldo; nieaktualny lub niedostępny odczyt nie daje prawa do nowych dwóch minut. To podgląd szkicu, a nie nielimitowana obsługa pełnej sesji. Dzielenie nagrania nie zeruje wspólnego czasu demo.
Niepowodzenia zatrzymujące pracę przed zakończeniem transkrypcji i jej podsumowania nie dochodzą do naliczenia czasu w tym demo. Udana, choć krótka, niedokładna lub częściowo użyteczna transkrypcja nadal może zużyć czas. Jeśli odpowiedź zaginie lub błąd nastąpi po naliczeniu, saldo mogło już się zmienić. Sprawdź bieżący stan przed ponowną próbą; błąd na ekranie nie jest obietnicą, że próba nie zużyła czasu.
Spisz zapisane nagranie fokusu w JotMe
Użyj najwyraźniejszej obsługiwanej kopii audio, którą masz. MP3, WAV i M4A są częstymi wyborami, ale znaczenie mają rzeczywisty kodek i odczytywalna długość. Link do spotkania, lista uczestników czy zdjęcie notatek nie są plikiem dźwiękowym. W razie potrzeby wyeksportuj nagranie z pierwotnej usługi; zmiana rozszerzenia nie konwertuje pliku. Obsługiwane zapisane wideo ma osobną stronę transkrypcji wideo na tekst.
- Otwórz zapisane nagranie i odtwórz je lokalnie. Sprawdź początek, koniec oraz kilka cichych lub nakładających się fragmentów, aby wiedzieć, co naprawdę zawiera źródło. Zachowaj oryginalną nazwę pliku i przesunięcie każdego wycinka.
- Wybierz lub upuść obsługiwane audio w demo i poczekaj na odczyt długości. Jeśli pliku nie da się odczytać, uzyskaj obsługiwany eksport albo rzeczywistą konwersję; ponawianie tego samego nieczytelnego pliku nie pomoże.
- Wybierz Transkrybuj. W oknie Sprawdź przed startem skontroluj Plik, Długość i Pozostały darmowy czas (audio), następnie Rozpocznij transkrypcję. Wybranie przygotowuje plik, a potwierdzenie uruchamia przetwarzanie. Wysyłaj tylko treść, którą wolno Ci przetwarzać zewnętrznie.
- Czytaj widoczne segmenty z czasem w języku nagrania. Język źródłowy jest rozpoznawany automatycznie; nie ma tutaj ręcznego wyboru języka źródłowego. Wyświetlane zakresy minut i sekund są roboczym odniesieniem do pliku, nie pomiarem czasu mówienia; wariant awaryjny zwykłego tekstu może mieć 00:00–00:00. Zachowaj oryginalne przesunięcie wycinka i sprawdź etykiety rozmówców oraz interpunkcję z nagraniem.
- Odtwórz odpowiadający fragment we własnym odtwarzaczu. Sprawdź słowa, przeczenia, granice wypowiedzi i to, czy rzeczywiście da się ustalić rozmówcę. Zaznacz niepewność i brakujący zakres zamiast uzupełniać luki tematyką rozmowy.
- Zapisz widoczny tekst w osobnym dokumencie roboczym wraz ze źródłem i statusem kontroli, zanim wybierzesz inny plik, rozpoczniesz nową transkrypcję, użyjesz Transkrybuj ponownie albo opuścisz stronę. Wynik jest lokalnym stanem strony; wybór innego pliku może go wyczyścić, nawet jeśli plik jest nieprawidłowy. Nie ma edytora w miejscu, przycisku Kopiuj wszystko ani pobierania transkrypcji. Jeśli przeglądarka pozwala zaznaczać tekst, wklej go i sprawdź; w przeciwnym razie zapisz krótki fragment ręcznie.
Wypróbuj
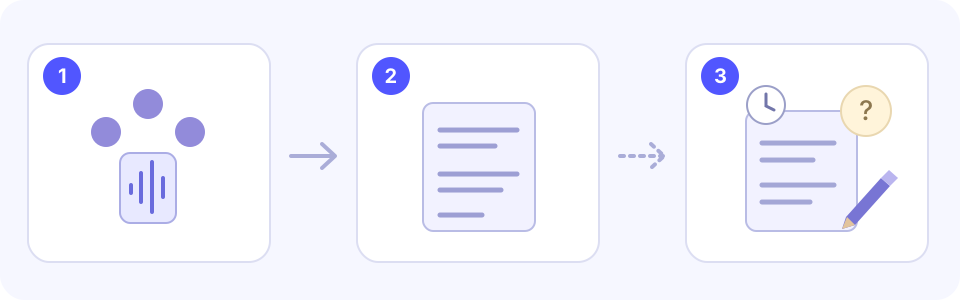
Przejdź od próbki do całego nagrania
- Najpierw zapisz próbkę w oddzielnym dokumencie i sprawdź ją. Transkrybuj ponownie otwiera to samo demo audio na tekst z tym samym wspólnym limitem; nie kontynuuje od przesunięcia ani nie odblokowuje dodatkowego darmowego czasu. Informacja o podglądzie nie dowodzi, że ukryta reszta została spisana lub zapisana.
- Dla dłuższego nagrania spełniającego warunki użyj osadzonego linku Załóż konto do aplikacji webowej JotMe. Zaloguj się lub utwórz konto i w razie potrzeby przejdź weryfikację oraz wdrożenie, potem wybierz Transcribe file w obszarze roboczym. Ponownie wskaż oryginalny obsługiwany plik lokalny, sprawdź długość, język oraz aktualne minuty konta i limity planu, a następnie potwierdź nowe przesłanie. Ani plik, ani zapisane poprawki, ani już przetworzona reszta nie przenoszą się automatycznie. Nie obiecujemy konkretnego limitu po rejestracji ani nieograniczonej długości.
- Zachowaj oryginalne nagranie i sprawdzaj z nim kolejne odcinki, łącznie z końcem. Zapisuj sprawdzone zakresy, a pozostałe zostaw jako niesprawdzone. Przy osobno przygotowanych wycinkach zachowaj pierwotną nazwę pliku i przesunięcie początku; dodaj to przesunięcie do czasów względnych szkicu i przy każdym żądaniu ponownie ustalaj rozmówców. Osobne przesłania nie łączą się automatycznie we wspólny klucz uczestników; tworzenie wycinków nie zeruje salda demo.
Otwórz stronę transkrypcji audio po zapisaniu obecnego tekstu
Sprawdzaj rozmówców wypowiedź po wypowiedzi
Zacznij od fragmentu, którego rozmówcę da się ustalić na podstawie dozwolonego źródła, a późniejsze wypowiedzi sprawdzaj oddzielnie. Jedna osoba może otrzymać kilka automatycznych etykiet, a jedna etykieta może błędnie połączyć kilka osób. Zamiana wszystkich etykiet Mówca 1 na P1 po jednym poprawnym przedstawieniu może roznieść błąd po całym dokumencie. Gdy dowody nie rozstrzygają sprawy, pozostaw rozmówcę danej wypowiedzi nieustalonego.
- Moderator: oddziel pytanie lub zachętę do odpowiedzi od wypowiedzi uczestnika. Nie licz pytania jako opinii uczestnika.
- Krótkie odpowiedzi: sprawdź w kontekście „tak”, „nie” i „u mnie też”. Głośniejszy głos w pobliżu nie dowodzi, kto odpowiedział cicho.
- Nakładanie się głosów: wpisz [nakładające się wypowiedzi] z odniesieniem czasowym. Przypisuj osobne wypowiedzi tylko wtedy, gdy rzeczywiście je słyszysz i potrafisz ustalić rozmówców. Nie składaj dwóch urwanych zdań w jeden pewny cytat.
- Niejasne słowa: oznacz [niesłyszalne] lub [niepewne słowo] w odpowiednim miejscu. Możliwą interpretację zachowaj w notatce, nie jako ustalony cytat.
- Zmiana głosu lub miejsca: sprawdź przypisanie po przerwie, zmianie mikrofonu lub przemieszczeniu. Nie wnioskuj o tożsamości ani cechach osoby z automatycznego numeru rozmówcy.
Fikcyjne „przed i po” w osobnym dokumencie roboczym. Etykiety szkicu są wymyślone i nie przedstawiają rzeczywistego wyniku JotMe. Popraw konkretną wypowiedź, a nie każde wystąpienie etykiety.
- 00:10 | Przed: M, wcześniej sprawdzony: „Jak sprawdzały się u was przypomnienia?” | Po: M, bez zmiany: „Jak sprawdzały się u was przypomnienia?” | Dowód: Zachowaj wcześniej zweryfikowane pytanie moderatora oddzielnie od odpowiedzi uczestników; późniejsza poprawka nie daje nowych dowodów o tej wypowiedzi.
- 00:24 | Przed: Mówca 1: „Lubiłem te przypomnienia, ale nie codziennie”. | Po: P2, przypisanie sprawdzone tylko dla tej wypowiedzi: „Lubiłem te przypomnienia, ale nie codziennie”. | Dowód: W fikcyjnej kontroli dozwolony materiał wideo nagrany równocześnie jest sprawdzany dokładnie przy tej wypowiedzi wraz z odpowiadającym audio; ustalony kod P2 ma oparcie dla tego fragmentu. Sam plan miejsc lub przedstawienie w innym momencie nie rozstrzygnęłyby sprawy.
- 00:27 | Przed: Mówca 1: „Nie dla mnie”. | Po: rozmówca nieustalony, nakładanie głosów: „Nie dla mnie”. | Dowód: W tej ilustracji słowa cichego uczestnika są rozróżnialne, ale dozwolone materiały nie ustalają autora. Nie przenoś poprawki z 00:24 na tę wypowiedź.
- Przykład nakładania się głosów podaje zakresy słów wypowiadanych jednocześnie; te wiersze pokazują wyłącznie zmianę przypisania. Zachowaj pierwotny szkic. Automatyczne etykiety z różnych plików lub żądań nie są wspólnym kluczem uczestników. Sprawdzony kod nie dowodzi anonimowości ani zgody na udostępnienie.
Fikcyjny przykład: zachowaj sprzeciw i niepewność
Wyłącznie ilustracja autorska: słowa, czasy i decyzje kontrolne poniżej są fikcyjne, nie pochodzą z przesłanego nagrania ani wyniku JotMe. Czasy są przykładowymi odniesieniami względem źródła, a nie pomiarem czasu mówienia. Takie same znaczniki nakładania A pokazują równoczesne fragmenty.
- [00:10] M, przypisanie sprawdzone: „Jak sprawdzały się u was przypomnienia?”
- [00:24] P2, przypisanie sprawdzone: „Lubiłem te przypomnienia, ale [nakładanie A: nie codziennie]”.
- [00:27] rozmówca nieustalony: „[nakładanie A: Nie dla mnie]”.
- Notatka kontrolna: W tej ilustracji słowa P2 i osobna przecząca odpowiedź są rozróżnialne; tożsamość cichszego rozmówcy pozostaje nieustalona. Zanim zastosujesz takie decyzje w prawdziwej transkrypcji, odtwórz odpowiedni fragment źródła. Nie zmieniaj tej wypowiedzi na P3 tylko dlatego, że P3 pojawia się dalej w szkicu. Jeśli równoczesnych słów faktycznie nie słychać, zachowaj [nakładające się wypowiedzi] zamiast tego wymyślonego brzmienia.
- Notatka analityczna: Pytanie moderatora daje kontekst i nie jest opinią uczestnika. Wycinek zawiera jedną warunkową pozytywną odpowiedź i osobny sprzeciw; „Nie dla mnie” odpowiada na to pytanie i nie dowodzi ogólnej niechęci do przypomnień. Nie pokazuje zgody całej grupy. Reszta sesji nie została sprawdzona.
Zapisuj poprawki i sprawdzony zakres
- Nagłówek: identyfikator sesji, plik źródłowy, długość, przesunięcie wycinka, język wypowiedzi, konwencja transkrypcji, data szkicu i data kontroli.
- Przy każdej wypowiedzi: czas względem źródła, stały kod rozmówcy lub etykieta nieustalenia, słowa i jawne znaczniki niepewności. Zachowaj pierwotny szkic do porównań.
- Rejestr poprawek: co zmieniono, kto sprawdził oraz źródło lub dozwolone odniesienie potwierdzające zmianę. Korektę pisowni oddziel od wywnioskowanego zamiaru.
- Zakres: wskaż odcinki sprawdzone odsłuchem oraz te niespisane lub niesprawdzone. Pominięty fragment nie dowodzi, że nikt nie mówił.
- Kopia do udostępniania: zgodnie z wymaganiami projektu usuń lub zastąp dane identyfikujące, stosując spójne kody i osobny rejestr zmian. Kontroluj kontekst, nie tylko nazwiska; zamiana na kody nie anonimizuje danych sama w sobie.
Wypełniony fikcyjny wpis w rejestrze, tylko dla wypowiedzi 00:24; Przykładowy weryfikator A to wymyślona osoba sprawdzająca. Wpis dokumentuje dowody przypisania, nie wywnioskowany zamiar ani tezę o całym pliku.
- Źródło / czas: FG-example / session-example.wav / oryginalne źródło 00:24; przesunięcie wycinka 00:00 (wszystko fikcyjne)
- Brzmienie lub etykieta szkicu: Mówca 1: „Lubiłem te przypomnienia, ale nie codziennie”.
- Poprawka: Tylko ta wypowiedź → P2. Zachowaj słowa i warunek; pozostaw znacznik nakładania A w transkrypcji roboczej.
- Dowód: Fikcyjny odsłuch odpowiadającego oryginalnego audio i dozwolony materiał wideo z tej samej wypowiedzi potwierdzają P2. Rozmówca nakładający głos przy 00:27 pozostaje nieustalony; decyzja nie zmienia późniejszych etykiet Mówca 1.
- Weryfikator: Przykładowy weryfikator A / przykładowa data kontroli 2026-10-21
- Status: Przypisanie sprawdzone tylko dla 00:24; słowa sprawdzone dla tego przykładowego fragmentu. Reszta sesji niesprawdzona; tożsamość przy 00:27 nieustalona.
- Korekty pisowni lub słów oddziel od interpretacji. Zamiany identyfikatorów zapisuj w odrębnym rejestrze anonimizacji lub kopii udostępnianej; żaden z rejestrów nie zmienia nagrania źródłowego.
Rozróżnialne równoczesne wypowiedzi zapisuj w osobnych wierszach. Nie sumuj długości segmentów jako dokładnego czasu mówienia każdej osoby: granice, nakładanie się głosów, brakujące słowa i przypisanie mogą być błędne. To osadzone demo nie ma potwierdzonego eksportu do kodowania badawczego, menedżera listy uczestników ani raportu czasu mówienia. Do własnego procesu analizy przenoś tylko tekst, który naprawdę zapisałeś.
Gdy nagranie grupy jest trudne do zrozumienia
- Cicha lub odległa mowa: wróć do najwyraźniejszego oryginału albo dozwolonej kopii zapasowej. Ponowne kodowanie nie odtworzy słów, które nigdy nie były słyszalne.
- Kilka ścieżek: każdą sprawdź z odniesieniem do źródła i przesunięciem. Więcej plików oznacza więcej kontroli, a automatyczne etykiety z osobnych żądań nie tworzą jednego klucza uczestników.
- Mieszane języki: poproś odpowiednią osobę biegle znającą język o sprawdzenie oryginału. Automatyczna detekcja nie daje gwarancji, a przetłumaczone zdanie nie naprawia błędnie usłyszanego słowa.
- Brak końca: sprawdź długość oryginału i pozostały zakres. Zachowaj oznaczenia nieobjętych fragmentów; nie zakładaj, że zachęta do rejestracji oznacza już zapisany ukryty tekst.
- Nieustalone nakładanie się głosów lub cytaty o ważnych konsekwencjach: zachowaj lukę i uzyskaj odpowiednią kontrolę człowieka przed użyciem fragmentu. Naturalnie brzmiący szkic nie wystarcza jako dowód cytatu ani autorstwa wypowiedzi.
Oddziel tłumaczenie i wnioski od transkrypcji
Jeśli tłumaczenie ma wychodzić od Twoich ręcznych poprawek, najpierw zapisz i sprawdź transkrypcję w języku oryginału we własnym dokumencie. Otwórz tłumaczenie tekstu, wybierz dostępny język źródłowy oraz obsługiwany docelowy i wklej sprawdzony fragment. Wysłany tekst jest tłumaczony po krótkiej przerwie; obowiązują własne aktualne limity tego narzędzia. Kody rozmówców, odniesienia czasowe, brzmienie źródłowe i wersję przetłumaczoną przechowuj oddzielnie, a potem sprawdź tłumaczenie. Tłumaczenie nie jest dosłownym cytatem w języku oryginalnym.
Przetłumacz sprawdzony fragment transkrypcji jako tekst
Alternatywny proces tłumaczenia audio wymaga nowego wybrania nagrania i tworzy własną transkrypcję, zanim przetłumaczy zwrócone segmenty. Nie importuje poprawek dokonanych w osobnym dokumencie. Ponownie porównaj niezależnie wygenerowane słowa i przypisanie z nagraniem; jeśli część tłumaczeń segmentów się nie powiedzie, może pozostać tekst oryginalny mimo już zużytego czasu transkrypcji. Podsumowanie ani płynne tłumaczenie nie naprawiają źle usłyszanego słowa, nie tworzą zgody grupy i nie ustalają tożsamości rozmówcy.
Przetłumacz zapisane audio na obsługiwany język do czytania
Przy rozmowie jeden na jeden skorzystaj z kontroli cytatów i rozmówców w poradniku wywiadu. Dla wykładu jednego prowadzącego poradnik wykładu opisuje notatki i terminologię. Fokus dodaje osobne zadanie: zachować interakcje między ludźmi bez wymyślania jednomyślności i bez wciskania niepewnych wypowiedzi w znane tożsamości.
Sprawdź transkrypcję wywiadu i cytaty
Sprawdź nagranie wykładu i terminologię
Wytyczne UConn dotyczące badań fokusowych
Przeczytaj rzeczywiste zasady prywatności JotMe przed przetwarzaniem zewnętrznym
Najczęstsze pytania
Jak zrobić transkrypcję nagrania fokusowego?
Zachowaj nagranie i odniesienie do źródła, wybierz zasady zapisu, wygeneruj szkic i odtwarzaj istotne wypowiedzi. Sprawdź słowa, przeczenia, nakładanie się głosów i przypisanie, a potem zapisz oddzielną sprawdzoną kopię roboczą. Osadzone narzędzie JotMe daje ograniczony podgląd w języku oryginału, nie kompletną transkrypcję badawczą z ustaloną tożsamością uczestników.
Czy JotMe automatycznie rozpozna każdego uczestnika?
Nie. Demo wyświetla segmenty z automatycznymi etykietami rozmówców, ale etykiety nie są zweryfikowaną tożsamością. Jedna osoba może otrzymać kilka etykiet albo kilka osób może zostać połączonych. Sprawdzaj poszczególne wypowiedzi na podstawie dozwolonych źródeł i zachowuj oznaczenia nieustalonego przypisania. Nie zmieniaj etykiety globalnie na podstawie jednego poprawnego fragmentu.
Jak zapisywać nakładające się lub niejasne wypowiedzi?
Oznacz fragment jawnie, np. [nakładające się wypowiedzi] lub [niepewne słowo], z odniesieniem czasowym. Rozróżnialnych rozmówców umieszczaj w osobnych wierszach tylko wtedy, gdy da się ustalić słowa i przypisanie. Możliwą interpretację zachowaj w notatce kontrolnej; nie zamieniaj domysłu w pewny cytat.
Czy w tym demo spiszę bezpłatnie cały fokus?
Nie zakładaj, że cała sesja grupowa jest tutaj darmowa. Limit żądania wynosi pięć minut, a początkowy dożywotni limit plików demo to 120 sekund wspólnych dla audio i wideo. Obowiązuje najkrótszy zakres: długość pliku, faktycznie pozostały czas lub limit żądania. Sprawdź potwierdzenie i widoczny zakres; wcześniejsze użycie może zmniejszyć saldo, a podział go nie resetuje. Transkrybuj ponownie otwiera to samo ograniczone demo. Dłuższe nagranie w osobnym procesie Transcribe file po zalogowaniu w aplikacji webowej wymaga nowego wybrania pliku i kontroli aktualnych limitów konta; rejestracja nie przetwarza ukrytej reszty ani nie przenosi tego pliku.
Czy tutaj poprawię, skopiuję wszystko lub wyeksportuję wynik?
Ten komponent nie ma edytora poprawek w miejscu, przycisku Kopiuj wszystko ani pobierania transkrypcji. Jeśli przeglądarka pozwala zaznaczać, skopiuj widoczny fragment, wklej do osobnego dokumentu i sprawdź; inaczej zapisz krótki fragment ręcznie. Zapisz go przed wyborem innego pliku, nową transkrypcją, Transkrybuj ponownie lub przejściem dalej. Tekst jest lokalnym stanem strony i może zniknąć po wyborze pliku, także nieprawidłowego zamiennika. Pełna strona audio otwiera to samo demo; proces konta jest oddzielny i nie zapisuje ani nie przenosi automatycznie bieżącego nagrania lub transkrypcji.
Czy kody uczestników anonimizują transkrypcję fokusu?
Nie. Wypowiedziane nazwiska, pracodawcy, miejsca i charakterystyczne doświadczenia nadal mogą kogoś identyfikować. Stosuj zatwierdzony w projekcie sposób udostępniania, spójne zamiany w osobnej kopii oraz odpowiedni rejestr zmian. Klucz prawdziwych nazwisk chroń osobno i sprawdzaj kontekst, nie tylko same nazwiska. Demo nie anonimizuje transkrypcji ani nie zatwierdza protokołu badania. Zamiana nazwiska w tekście nie usuwa go z oryginalnego audio; przed przesłaniem osobno sprawdź nagranie i uprawnienia do przetwarzania zewnętrznego.
Czy podsumowanie lub tłumaczenie zastąpi kontrolę źródła?
Nie. Podsumowanie może pominąć sprzeciw lub warunki, a tłumaczenie nie naprawia błędnie usłyszanego słowa ani złej etykiety rozmówcy. Najpierw sprawdź brzmienie oryginalne i przypisanie. Aby zachować te poprawki jako wejście, wklej sprawdzony fragment do tłumaczenia tekstu z właściwymi obsługiwanymi językami. Tłumaczenie audio zaczyna natomiast od ponownie wybranego nagrania i tworzy własną transkrypcję bez ręcznych poprawek, więc słowa wymagają kolejnej kontroli źródła. Oddzielaj źródło, tłumaczenie i analizę; niesprawdzony podgląd nie ustala poglądu całej grupy.